
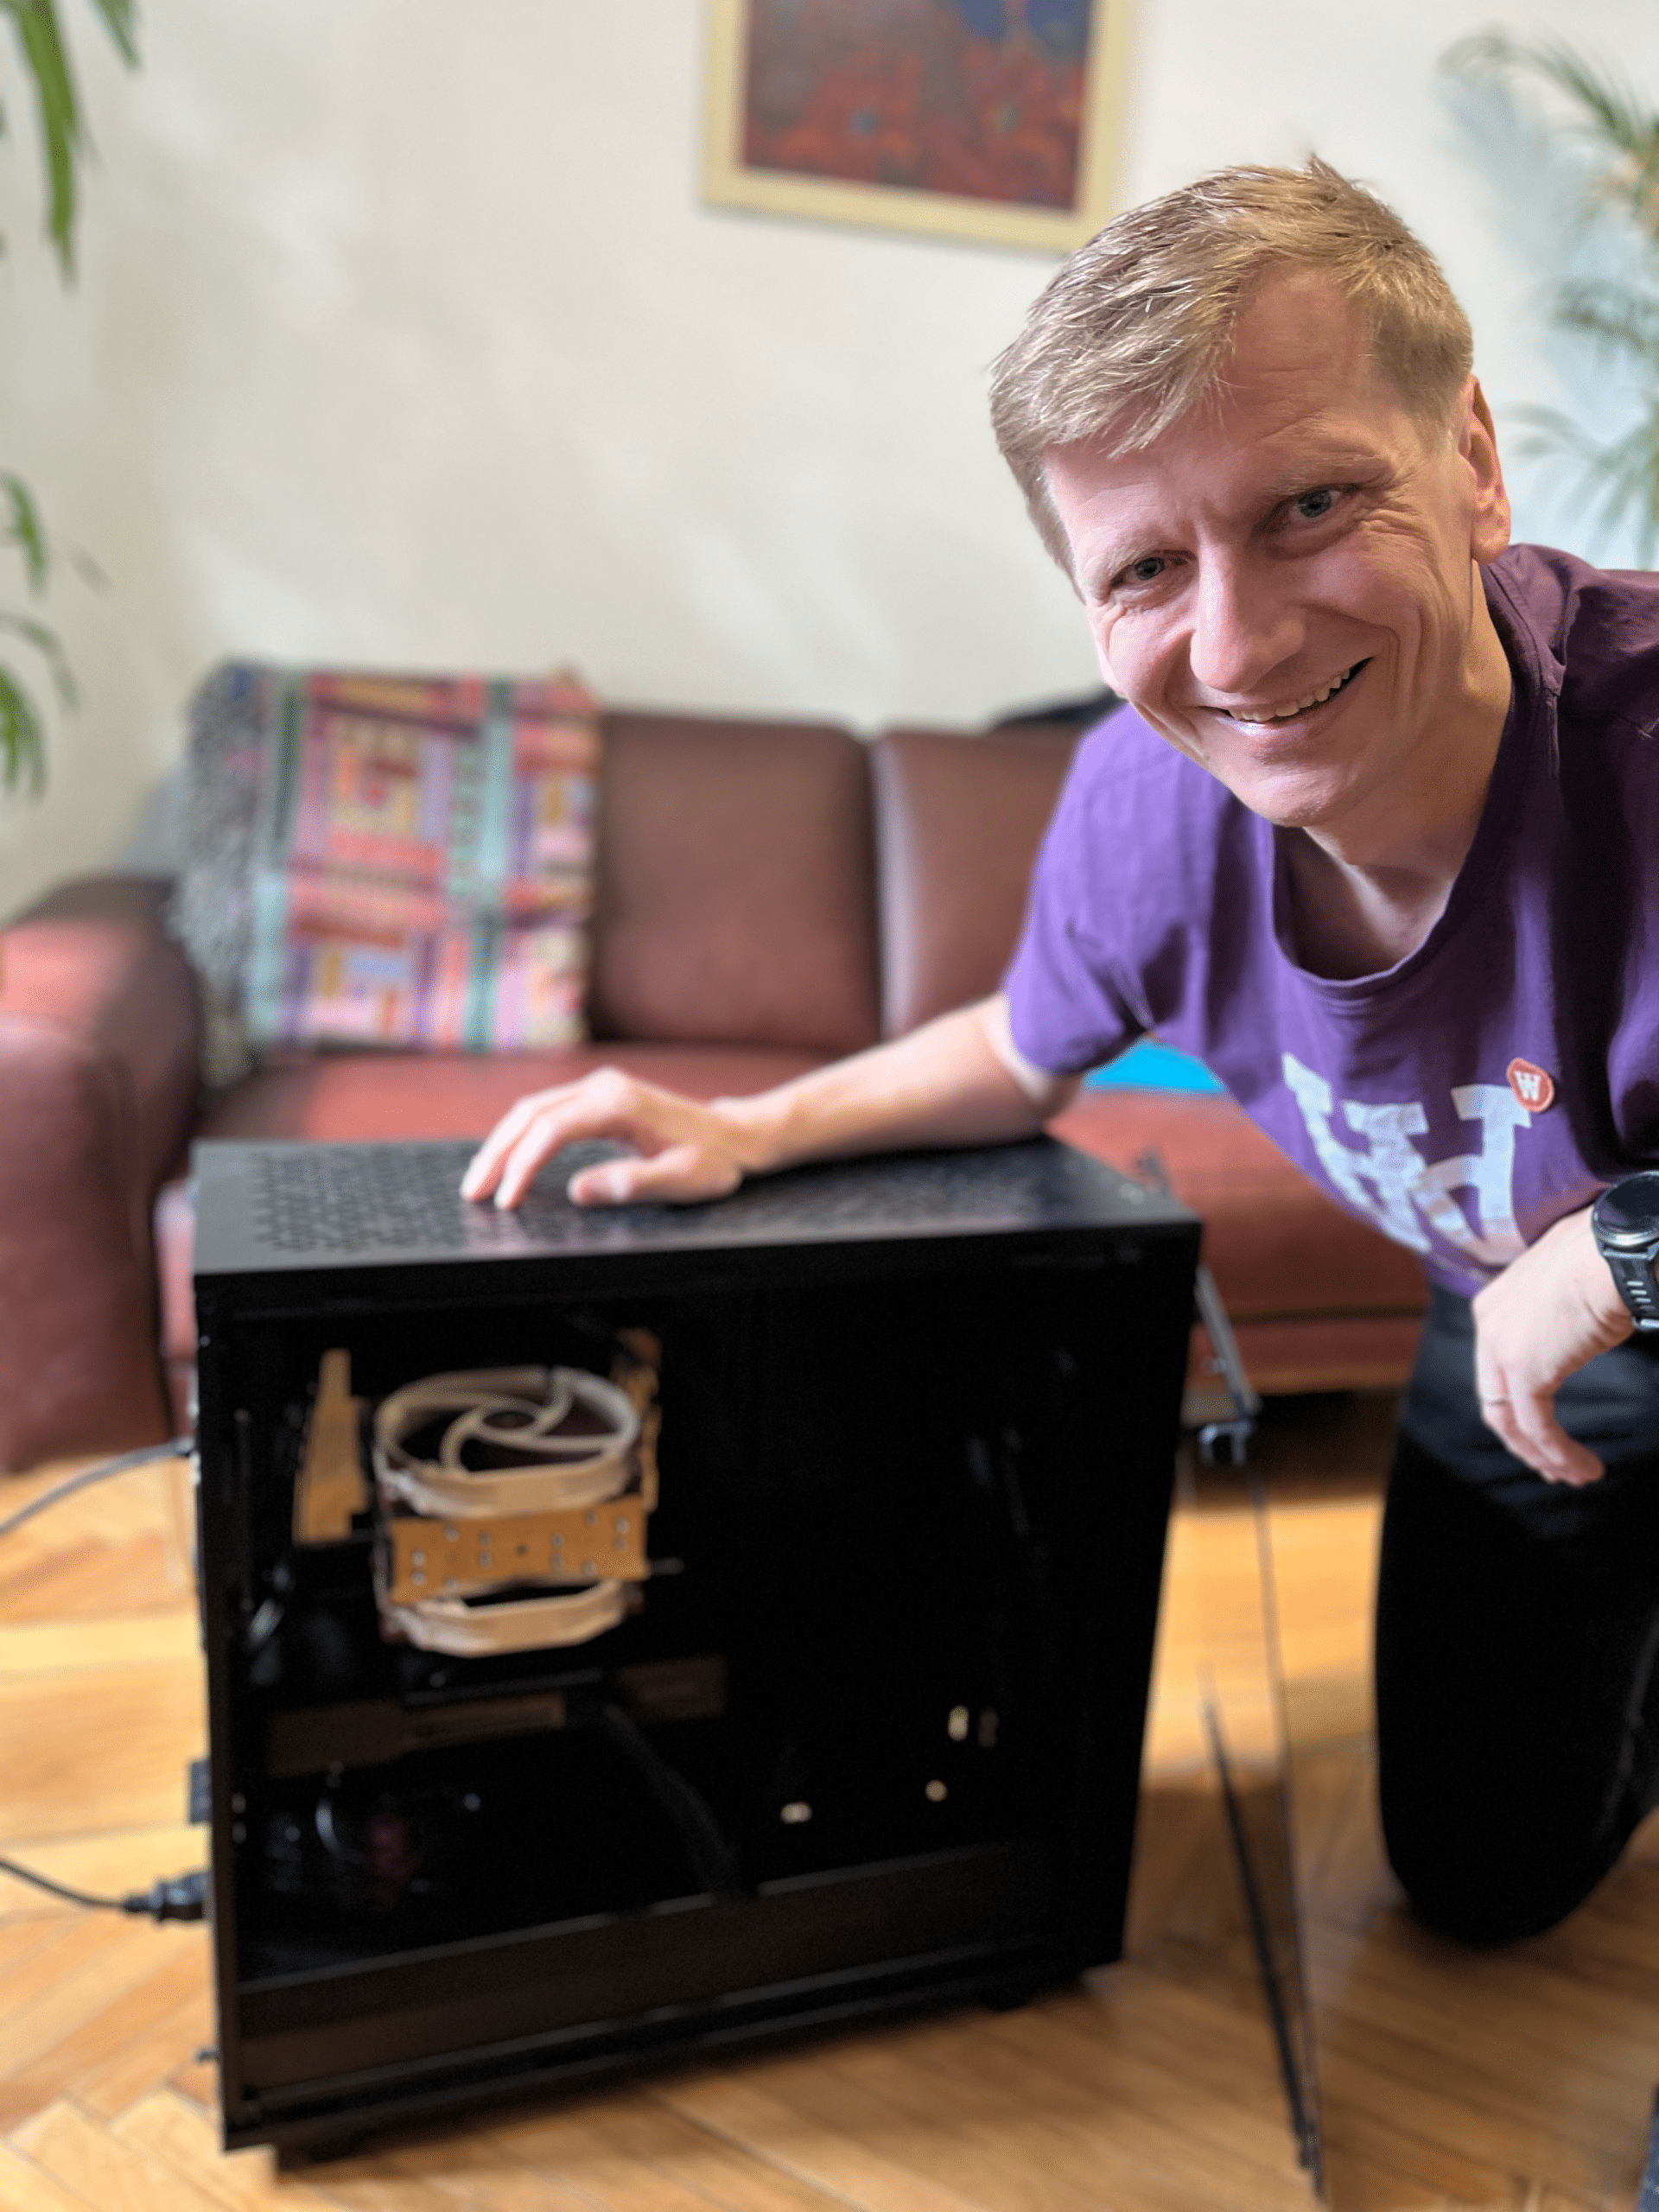
Eigene KI statt Cloud. Datensouveränität statt API-Abhängigkeit. Der Plan war klar, die Hardware beeindruckend, die Vorfreude groß. Wir haben uns einen Server hingestellt, der noch vor zwei Jahren als Supercomputer durchgegangen wäre – Threadripper, Blackwell GPU, 96 GB VRAM – alles zusammengebaut, alles konfiguriert, Modell geladen. Und dann? Stille. Schwarz. Aus. Kein Bluescreen, kein Log-Eintrag, kein Lebenszeichen. Nur ein Kippschalter am Netzteil, der irgendwie zum einzigen Startknopf geworden war. Lest weiter und profitiert von unseren Erfahrungen.
Warum wir keine Cloud wollen – und Balrog gebaut haben
Als Cybersecurity-Unternehmen arbeiten wir täglich mit Daten, die schlicht nicht über fremde API-Endpunkte wandern dürfen: Pentest-Befunde, Security Findings, interne Analysen. Was nicht in die Cloud geht, kann dort auch nicht abgegriffen werden. ChatGPT und Co. sind für uns keine Option.
Also: eigene KI, eigene Server, volle Kontrolle. Balrog ist unser internes LLM-System – AMD Threadripper 7960X, NVIDIA RTX PRO 6000 Blackwell mit 96 GB VRAM, 256 GB RAM. Hardware, die man noch vor zwei Jahren als Supercomputer bezeichnet hätte.
Das Symptom: GPU-Workstation stirbt ohne Vorwarnung
Die Workstation läuft. GPU-Temperatur stabil, Speicherauslastung normal, PCIe-Link auf Gen5 x16, LLM-Inferenz mit 262.144 Token Kontext läuft durch. Und dann – totale Stille. Kein Kernel Panic. Kein Bluescreen. Kein NVIDIA Xid-Fehler. Kein Log-Eintrag. Nada.
Der Power-Knopf vorne reagiert nicht mehr. Der einzige Weg, Balrog wieder zu starten, ist der Kippschalter am Netzteil hinten. Nur der. Kein anderer Weg.
Die Fehlersuche: Alles negativ – und das ist der eigentliche Befund
In der Security kennt man das Prinzip: Die Abwesenheit von Beweisen ist selbst ein Beweis. Wenn alle Monitoring-Schichten gleichzeitig schweigen, liegt das Problem tiefer als Software.
Was wir geprüft haben:
- Kernel-Logs (journalctl): Kein Panic, kein Watchdog-Timeout, kein Segfault
- NVIDIA GPU-Diagnostik: Kein Xid-Fehler, keine Temperaturwarnung
- pstore (Persistent Storage): Leer – kein Firmware-Level-Crash-Record
- netconsole: Kein Output am Empfänger-Host
- rasdaemon: Null MCE-Events, null PCIe-Fehler, null Speicherfehler
- GPU-Telemetrie bis zur letzten Sekunde: Moderate Last, stabile Temperaturen, kein Power-Limit-Throttling
📌 Fazit: Alle Logging-Schichten haben gleichzeitig aufgehört zu schreiben – weil ihnen der Strom abgeschaltet wurde. Der Fehler liegt auf Hardware-Ebene, unterhalb jeder Software-Monitoring-Möglichkeit.
Der Täter: Multi-Rail OCP – das Netzteil schützt sich vor uns
Unser be quiet! Dark Power Pro 13 mit 1.600 Watt verteilt seine Leistung nicht über eine einzige Leitung, sondern über sechs unabhängige 12V-Rails. Jede Rail hat ihren eigenen Überstromschutz: OCP bei ~55 Ampere, also ~660 Watt pro Rail.
Das Problem in Zahlen: Die RTX PRO 6000 Blackwell zieht im Dauerbetrieb 600 Watt – das sind bereits 91 % des Per-Rail-Limits. Bei LLM-Inferenz erzeugen Attention-Layer und Matrixmultiplikationen explosive, kurzzeitige Lastspitzen. Tests an vergleichbaren Blackwell-GPUs (RTX 5090) haben transiente Spikes von 128–157 % des TDP gemessen – also 770 bis über 900 Watt für Mikrosekunden.
Das reicht, um die Per-Rail-OCP zu triggern. Und OCP latcht: Das Netzteil schaltet nicht kurz ab und wieder ein – es geht in einen dauerhaften Abschaltzustand. Aufheben lässt sich das nur durch vollständiges Trennen vom Netz.
Warum funktioniert der Power-Knopf dann nicht mehr? Wenn die OCP latcht, verliert das Mainboard die Standby-Spannung (5V_SB). Ohne 5V_SB kann es das PS_ON#-Signal nicht ans Netzteil senden – der Startknopf vorne ist physisch tot. Erst wenn der Kippschalter hinten die Kondensatoren entlädt, setzt sich die Verriegelung zurück.
Die Lösung: Overclocking Key (OCK) auf Single-Rail umschalten
Das be quiet! Dark Power Pro 13 hat einen physischen Schalter auf der Rückseite: den Overclocking Key (OCK). Im Auslieferungszustand: Multi-Rail-Modus. Einmal umgelegt: alle sechs 12V-Rails werden zu einer einzigen, massiven Rail zusammengeschlossen.
| Modus | OCP-Limit | Ergebnis |
|---|---|---|
| Multi-Rail (Standard) | ~660 W pro Rail | GPU-Spikes triggern OCP → Latch-Off |
| Single-Rail (OCK aktiv) | ~2.240 W (140 % Gesamt) | Max. Systemlast ~1.440 W → kein Problem |
Das Netzteil hatte nie zu wenig Gesamtleistung – 1.600 Watt Dauerlast, bis zu 3.200 Watt für transiente Spitzen. Das Problem war die künstliche Per-Rail-Limitierung. Ein Schalterflip, und Balrog läuft stabil.
So geht’s:
- System herunterfahren, Netzteil ausschalten
- OCK-Schalter von Multi-Rail auf Single-Rail umlegen
- Starten, LLM-Inferenz laufen lassen
- Keine Crashes mehr → Root Cause bestätigt ✓
Was man sonst noch im Blick haben sollte
- GPU-VBIOS prüfen: Frühe RTX PRO 6000 Blackwell hatten fehlerhafte Firmware (Version 98.02.52.00.2). Prüfen via
nvidia-smi --query-gpu=vbios_version --format=csv– bei betroffener Version: NVIDIA-Support kontaktieren. - PCIe Gen5 → Gen4 testen: Gen5 arbeitet an der Grenze der Signalintegrität. Ein Downgrade kostet 1–2 % GPU-Leistung, eliminiert aber PCIe-Fehler als mögliche Ursache.
- BIOS-Einstellungen härten: Global C-States, ASPM und DF C-States deaktivieren. AMD empfiehlt das explizit für GPU-Workstation-Setups – diese Stromspar-Features können bei Hochlast-Workloads zu Instabilitäten führen.
- Kill-A-Watt: Ein Leistungsmessgerät zwischen Steckdose und Netzteil schafft Klarheit. Fällt der Wert beim Crash abrupt auf 0 W, ist die OCP-Latch bestätigt.
Fazit: Wenn der Täter ein Schalter ist
Das Netzteil hat nicht versagt. Es hat exakt das getan, wofür es gebaut wurde – und dabei Balrog regelmäßig den Strom abgedreht. Die neue Generation KI-GPUs bringt Stromanforderungen mit, für die klassische Multi-Rail-Konfigurationen nicht ausgelegt sind. Wer lokale LLM-Inferenz auf High-End-Hardware betreibt, sollte das auf dem Schirm haben – bevor er Tage mit Software-Debugging verbringt, während die Ursache ein Schalter am Netzteil war.
Wenn ihr wissen wollt, wie es um eure externe Angriffsfläche steht – was Angreifer von außen über euer Unternehmen sehen – jetzt kostenlos prüfen lassen.
Quellen, die bei der Lösung geholfen haben:
- Intel ATX 3.0 Multi Rail Power Supply Design Guide – Over-Current Protection Spezifikation: edc.intel.com
- Tom’s Hardware – be quiet! Dark Power Pro 13 1300W PSU Review: tomshardware.com
- NVIDIA Developer Forums – RTX PRO 6000 Blackwell: Recurring full chip reset during sustained LLM inference: forums.developer.nvidia.com
- Level1Techs Forum – Threadripper 7000 / WRX90 / TRX50 System Build and Stability Issues Survey: forum.level1techs.com
- AMD Instinct Documentation – Recommended BIOS Settings for GPU Workloads: instinct.docs.amd.com
- be quiet! Dark Power Pro 13 1600W – Produktspezifikation: bequiet.com
